Sur une boutique en ligne, « commande confirmée » veut dire quelque chose de très concret : le client peut attendre son colis. Côté application, cette promesse repose pourtant sur plusieurs traitements. Il faut enregistrer la commande, prévenir le service d’expédition, puis lancer sa préparation. Et ces étapes ne se passent pas forcément dans le même processus, ni dans la même base.
C’est un sujet que je retrouve dans mon travail sur les plateformes PHP/Symfony et les flux Kafka alimentés par CDC : dès qu’un traitement continue ailleurs, je dois prévoir comment il reprend après une interruption. Un service qui redémarre ne sait pas spontanément ce que le précédent a laissé en cours.
Je prends ici un exemple de commande et d’expédition pour montrer comment je construis cette reprise avec une outbox transactionnelle, MySQL et Kafka.
Pourquoi enregistrer puis publier ne suffit pas
Imaginons une API Symfony qui reçoit une commande. Elle l’enregistre dans MySQL, puis publie un événement OrderCreated dans Kafka. Le service d’expédition écoute cet événement pour créer une préparation. Dans cet exemple simplifié, la commande est créée directement à l’état confirmé ; le paiement reste hors du périmètre.
Le code ressemble à ceci :
$orderRepository->save($order);       // commit SQL
$publisher->publish($orderCreated);  // publication Kafka
Quand tout fonctionne, la commande 42 apparaît dans la base, Kafka reçoit l’événement et l’expédition démarre. Le problème arrive si le processus s’arrête entre les deux instructions. La commande existe, mais le service d’expédition ne sait même pas qu’il devrait s’en occuper.

On pense facilement à ajouter un retry. Mais que va-t-on retenter au redémarrage ? L’événement n’est ni dans Kafka, ni enregistré quelque part comme étant à envoyer. Un try/catch ou un callback après le commit ne peut pas aider si le processus disparaît avant de les exécuter.
Publier avant d’enregistrer la commande inverse le risque : Kafka peut recevoir un événement pour une transaction qui échoue ensuite. Et entourer les deux lignes d’une transaction SQL ne rend pas Kafka participant de cette transaction. Le rollback de MySQL ne rappelle pas un message déjà publié.
C’est le problème du dual write : une même opération métier dépend de deux écritures dans des systèmes indépendants. Pour le résoudre, je commence par ramener ce qui doit être atomique dans une seule base.
Enregistrer la commande et l’événement ensemble
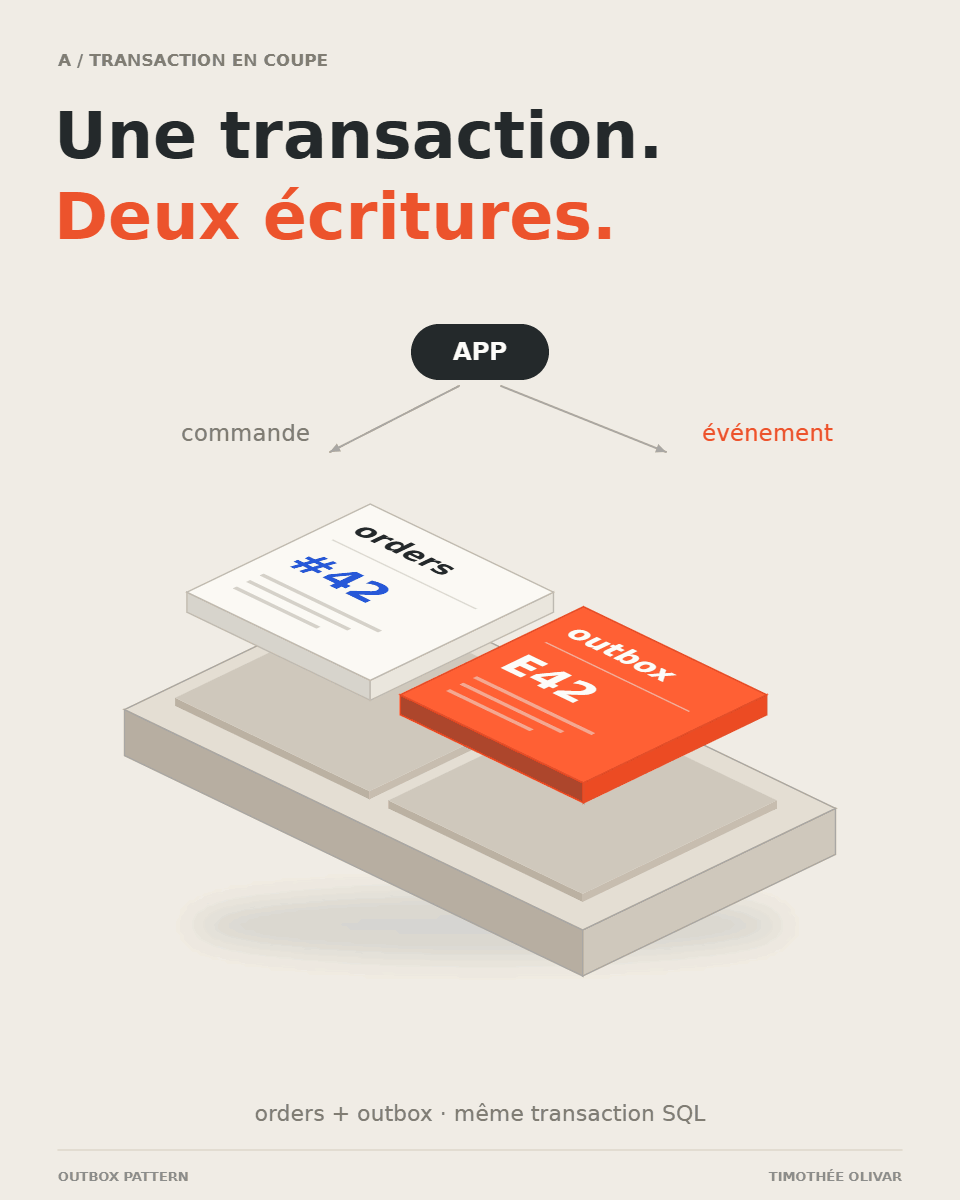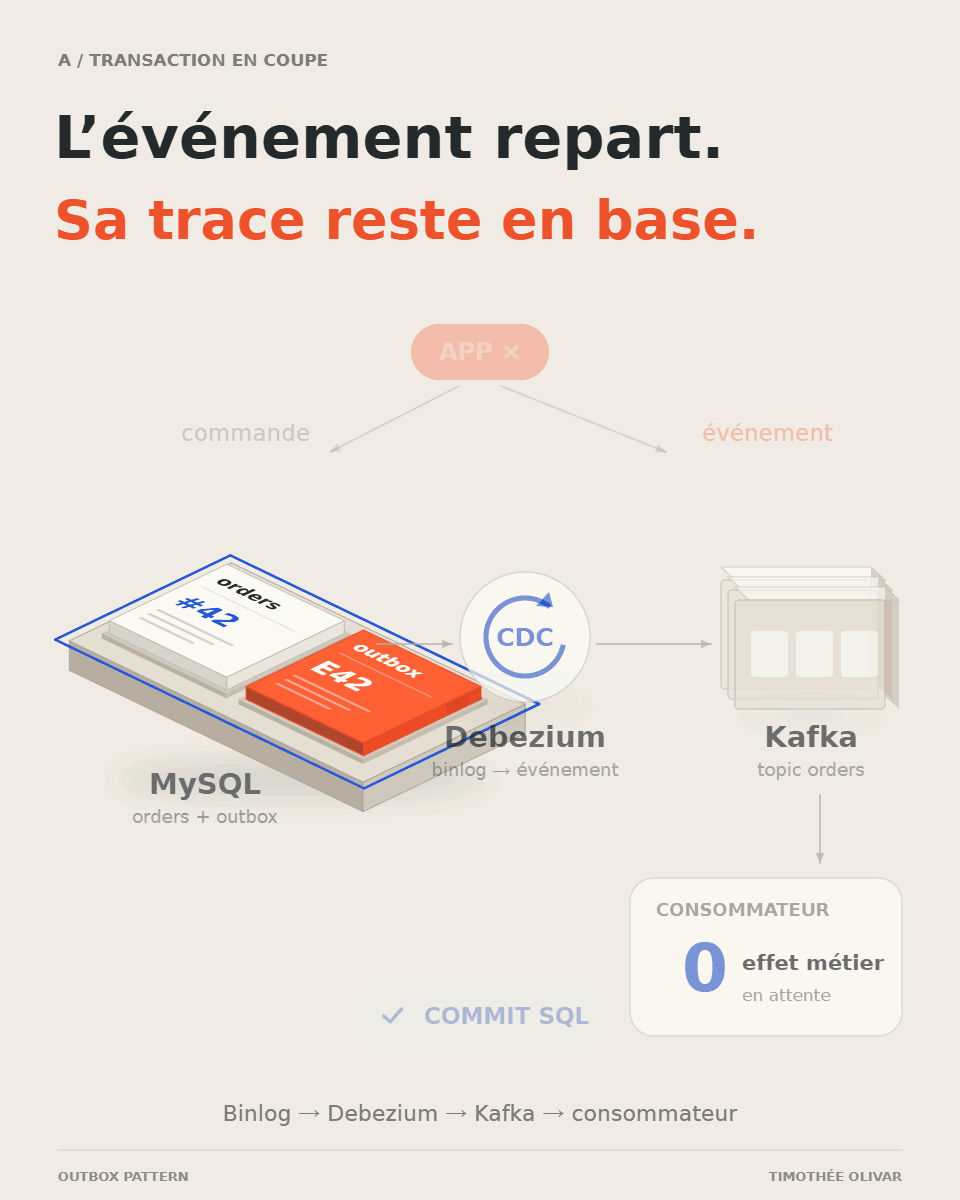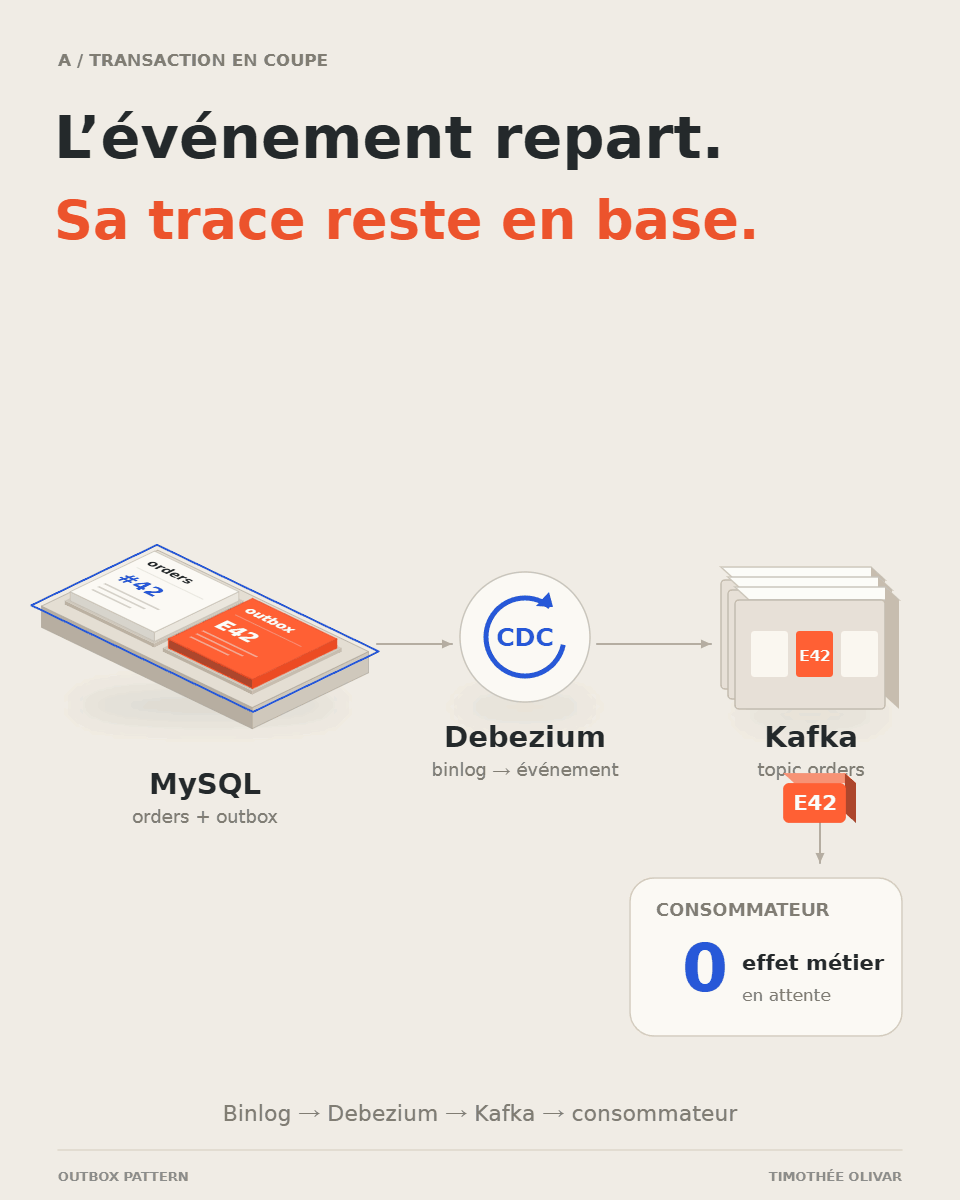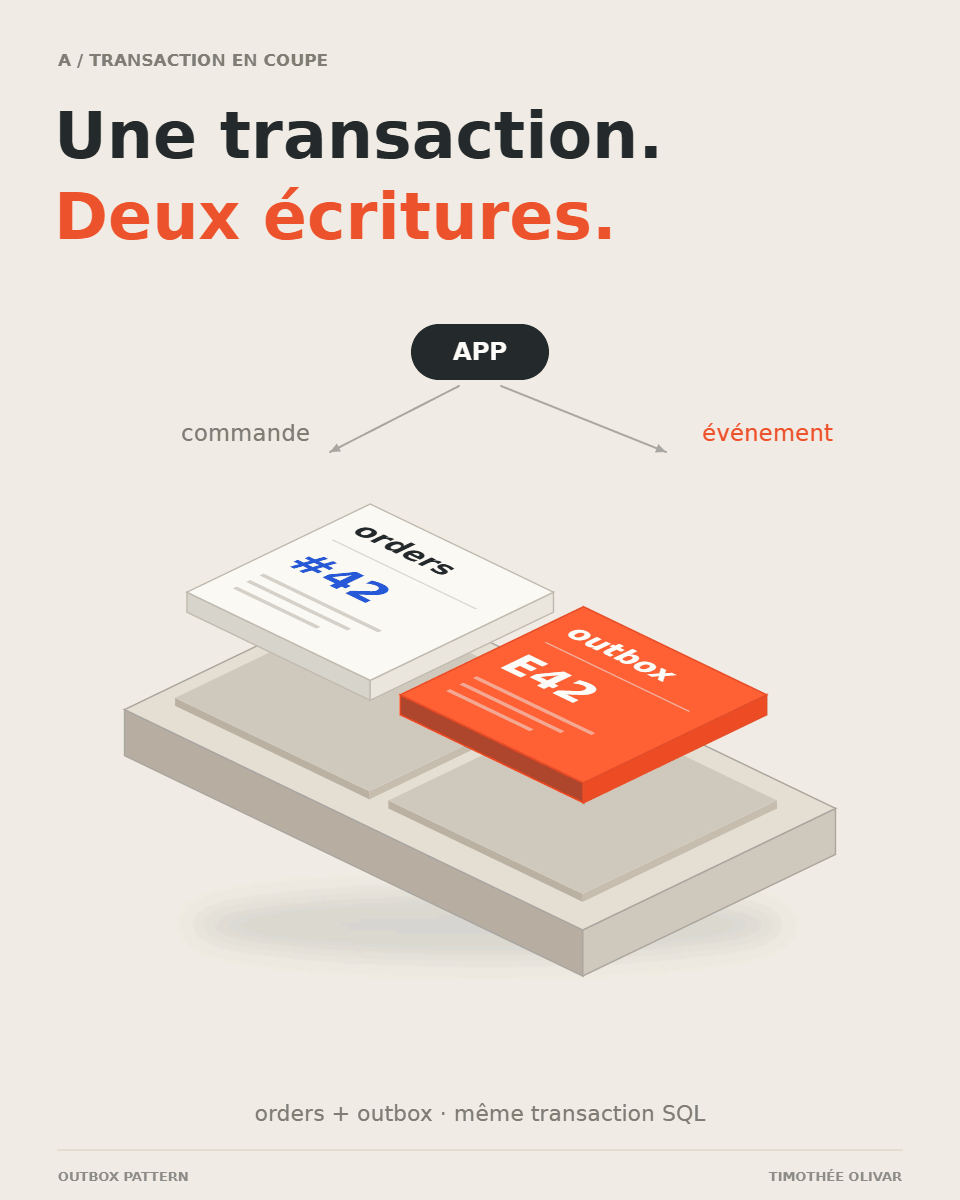
L’idée de l’outbox est assez simple : au moment où je valide la commande, j’enregistre aussi l’événement qu’il faudra transmettre. Une table orders contient l’état métier ; une table outbox contient les messages destinés à sortir de l’application. Un autre processus s’occupera de leur publication.
Le point décisif est d’utiliser la même connexion et la même transaction SQL pour les deux écritures. Avec des tables InnoDB, le commit valide la commande et son événement ensemble. Si l’une des insertions échoue, la transaction est annulée.
Voici une table d’outbox minimale pour la suite de l’exemple :
CREATE TABLE outbox (
    id            VARCHAR(64)  NOT NULL PRIMARY KEY,
    aggregatetype VARCHAR(100) NOT NULL,
    aggregateid   VARCHAR(100) NOT NULL,
    type          VARCHAR(100) NOT NULL,
    payload       JSON         NOT NULL
) ENGINE=InnoDB;
Les noms aggregateid et aggregatetype viennent du modèle attendu par l’Event Router de Debezium. Ici, l’« agrégat » est simplement la commande : aggregateid vaut 42 et aggregatetype vaut order. Le champ id identifie, lui, l’événement. Je l’appelle E42 dans les schémas pour faciliter la lecture ; dans l’application, j’utilise un identifiant unique, par exemple un UUID.
Une commande peut produire plusieurs événements, chacun avec son propre identifiant. payload contient les données utiles au destinataire ; type indique la nature de l’événement.
Dans un service applicatif Symfony, j’écris les deux lignes avec Doctrine DBAL :
use Doctrine\DBAL\Connection;

$payload = json_encode([
    'orderId' => $orderId,
    'schemaVersion' => 1,
], JSON_THROW_ON_ERROR);

$db->transactional(function (Connection $db) use (
    $orderId, $eventId, $payload,
): void {
    $db->insert('orders', [
        'id' => $orderId,
        'status' => 'confirmed',
    ]);
    $db->insert('outbox', [
        'id' => $eventId,
        'aggregatetype' => 'order',
        'aggregateid' => (string) $orderId,
        'type' => 'OrderCreated',
        'payload' => $payload,
    ]);
});
Dans ce fragment, $db est une connexion DBAL et les identifiants sont générés avant l’appel. Le helper transactional() ouvre la transaction, la valide si la fonction se termine normalement et l’annule si une exception remonte. Je garde volontairement peu de champs pour montrer cette frontière ; une vraie commande porte aussi ses lignes, son adresse et ses règles de validation.
Reprenons maintenant la panne après le commit. La commande 42 existe toujours, mais E42 existe aussi. Au redémarrage, il reste donc quelque chose à transmettre. Si la panne survient avant le commit, aucune des deux écritures n’est validée.
La publication peut attendre ; son contenu, lui, est déjà enregistré. En contrepartie, l’expédition devient cohérente avec la commande après un délai. L’interface doit pouvoir afficher « confirmée, en attente de préparation » pendant ce temps, sans laisser croire que le colis est déjà parti.
Faire sortir l’événement : un worker ou Debezium
L’outbox ne publie rien toute seule. Il lui faut un relais, et je choisis son fonctionnement selon l’infrastructure déjà en place.
Pour une application qui n’utilise pas de CDC, un worker peut lire régulièrement les lignes en attente, les publier dans Kafka, puis enregistrer la confirmation de publication. C’est le polling. Cette variante demande des informations supplémentaires dans la table, comme une date de publication et une réservation temporaire pour répartir le travail entre workers. La réservation doit expirer si son propriétaire tombe.
Avec une plateforme qui exploite déjà Debezium, je peux utiliser le journal de MySQL. Ce journal, le binlog, garde les changements de la base. Debezium le lit pour capturer les insertions dans l’outbox : c’est le Change Data Capture, ou CDC. L’Event Router transforme ensuite ces changements en messages destinés à Kafka.

Je sépare donc deux responsabilités : le code PHP décide qu’un événement métier existe ; le relais se charge de le transporter. Capturer directement toutes les modifications de orders ne dit pas forcément la même chose. Une correction d’adresse et une validation de commande sont deux changements de ligne, mais l’expédition n’en attend pas le même comportement.
Pour rendre le passage vers Kafka concret, voici le fragment de configuration de l’Event Router correspondant à notre exemple :
{
  "transforms": "outbox",
  "transforms.outbox.type": "io.debezium.transforms.outbox.EventRouter",
  "transforms.outbox.route.by.field": "aggregatetype",
  "transforms.outbox.route.topic.replacement": "outbox.event.${routedByValue}",
  "transforms.outbox.table.fields.additional.placement": "type:header:eventType"
}
Avec aggregatetype = order, le topic de sortie est outbox.event.order. Par défaut, aggregateid fournit la clé Kafka et id est transmis dans un en-tête. L’option ajoutée ici expose aussi type dans l’en-tête eventType : le consommateur reçoit donc la clé 42, l’identifiant E42 et le type OrderCreated, avec le payload de la commande.
Ce fragment complète un connecteur MySQL déjà configuré. Il faut encore choisir la sérialisation et limiter la transformation aux messages de l’outbox, avec un prédicat adapté ; les messages techniques du connecteur n’ont pas tous la même structure. La documentation de l’Event Router détaille ces réglages.
Le choix entre polling et CDC porte surtout sur ce que l’équipe sait exploiter. Je n’ajoute pas Kafka Connect et Debezium uniquement pour éviter un petit worker si l’application n’en a pas besoin. À l’inverse, quand cette infrastructure existe déjà, suivre le binlog évite de construire un mécanisme de réservation des lignes.
Recevoir deux fois E42 sans préparer deux colis
La commande peut désormais rejoindre le service d’expédition après une panne. Il reste une conséquence de cette capacité de reprise : un même événement peut être livré plusieurs fois.
Prenons un cas précis. Le consommateur reçoit E42 et crée la préparation de la commande 42 dans sa base. Il tombe ensuite, juste avant d’enregistrer sa progression dans Kafka. Cette progression est un offset : la position à partir de laquelle le consommateur pourra reprendre sa lecture.
Au redémarrage, Kafka lui présente à nouveau E42, puisque la progression n’a pas été validée. Le premier traitement a pourtant réussi. Si le consommateur crée une préparation à chaque réception, la même commande en aura deux.
C’est ici que j’utilise l’idempotence : recevoir à nouveau le même événement doit laisser le même résultat métier. Une manière de l’obtenir consiste à conserver les identifiants déjà traités dans une table processed_events, avec une clé unique (consumer_name, event_id).
L’algorithme tient en quelques étapes :
DÉBUT de transaction dans la base du consommateur
  Insérer ("shipping-preparation-v1", E42) dans processed_events
  Créer la préparation de la commande 42
COMMIT
Puis : enregistrer la progression Kafka
La trace de traitement et la préparation sont écrites dans une seule transaction locale, dans la base du consommateur. Si la préparation échoue, la trace est annulée avec elle et E42 pourra être retenté. Si le commit réussit, cette trace permettra de reconnaître E42 à son prochain passage.

Lors d’une nouvelle réception, l’insertion de la même clé échoue. Le handler annule cette tentative et considère ce doublon comme déjà traité, puis la progression Kafka peut être enregistrée. Je reconnais uniquement le conflit sur cette clé : une autre erreur SQL reste une erreur à traiter.
La contrainte en base protège aussi deux workers qui reçoivent E42 en même temps. Une vérification SELECT suivie d’un INSERT ne suffit pas : les deux peuvent lire « absent » avant que l’un d’eux ait écrit.
Le nom shipping-preparation-v1 distingue ce traitement de la facturation, qui peut aussi avoir besoin d’E42. Je le garde stable entre les instances et les redéploiements pour conserver la déduplication.
Où s’arrête cette garantie ?
À ce stade, nous savons reprendre la création d’une préparation locale. Mais créer une ligne shipment et demander au transporteur de venir chercher le colis sont deux opérations différentes.
Si le transporteur accepte la demande mais que sa réponse se perd, le worker ignore si l’expédition a été créée. Renvoyer la requête avec un nouvel identifiant risque alors de créer une seconde expédition. Quand l’API le permet, j’utilise une clé d’idempotence stable, par exemple shipment:42:initial, identique à chaque tentative de cette opération. Sinon, je cherche l’expédition par sa référence et je prévois une réconciliation avant de relancer une demande au résultat inconnu.
Le même raisonnement s’applique à l’entrée de l’API : un client qui retente sa commande après un timeout ne doit pas créer deux commandes. L’outbox ne remplace pas cette protection. De même, dédupliquer E42 ne bloque pas E43 si les deux demandent la même préparation ; une contrainte métier sur la commande peut être nécessaire en complément.
Il reste enfin l’ordre des événements. Si la commande 42 est annulée, le service d’expédition doit pouvoir interpréter OrderCreated puis OrderCancelled sans recréer ensuite une préparation annulée. J’utilise une clé Kafka stable par commande pour regrouper ses événements dans une partition, et je vérifie l’ordre du relais comme celui des retries. Une version métier permet de détecter un événement ancien ou un trou dans la séquence ; elle ne reconstitue pas un événement absent.
Une transaction Kafka ne rend pas atomiques, à elle seule, les écritures MySQL et l’appel au transporteur.
Les tests de panne qui rendent le flux crédible
Pour vérifier cette architecture, je pars du résultat attendu : après reprise, la commande 42 doit avoir une seule préparation, et son expédition doit avoir un état connu. Je coupe ensuite le traitement aux endroits où l’on change de système.
| Moment de la coupure | Résultat attendu après reprise |
|---|---|
| Avant le commit de la commande | Aucune commande validée, aucun événement à publier |
| Après le commit, avant publication | E42 est transmis par le relais |
| Avant le commit de la préparation | Trace et préparation annulées, E42 peut être retraité |
| Après ce commit, avant validation de l’offset | E42 revient, sans créer une deuxième préparation |
| Deux traitements simultanés d’E42 | Une seule préparation est validée |
| Réponse du transporteur perdue | L’expédition est retrouvée ou le retry utilise la même clé |
Je vérifie aussi que les consommateurs parallèles ne valident pas un offset au-delà d’un message précédent encore en échec dans la même partition. Sinon, la reprise peut sauter le travail qu’il fallait justement conserver.
Ces tests couvrent des interruptions courtes. Pour les arrêts longs, la conservation des données devient déterminante : Debezium doit encore pouvoir accéder au binlog nécessaire à sa reprise, et les traces de déduplication doivent couvrir la période de replay autorisée. Garder ces traces sept jours tout en permettant de rejouer six mois de messages expose à nouveau aux doublons.
Avec Debezium, la progression se lit dans les positions du connecteur ; il ne revient pas marquer chaque ligne d’outbox comme envoyée. Le nettoyage de la table doit donc être pensé avec la stratégie de reprise, sans appliquer aveuglément le modèle d’un worker par polling.
Enfin, je surveille le délai entre la validation d’une commande et sa préparation, en plus du retard du connecteur et des erreurs de traitement. Un flux peut conserver tous ses événements et laisser malgré tout des commandes attendre pendant des heures.
C’est ce que j’attends de l’outbox : pouvoir reprendre une commande dont le traitement s’interrompt, sans avoir à retrouver à la main ce qu’il manque. La table rend cette reprise possible. Le relais, le consommateur et le suivi du résultat métier permettent d’aller jusqu’au colis.
Références pour approfondir
- Chris Richardson : Transactional outbox, pour le problème des deux écritures et le rôle du relais.
- Doctrine DBAL : Transactions, pour la frontière transactionnelle utilisée dans le code PHP.
- Debezium : Outbox Event Router, pour adapter la table, le routage et le format des messages.
- Debezium : MySQL connector, pour configurer le binlog et comprendre les conditions de reprise.
- Chris Richardson : Idempotent Consumer, pour la déduplication au sein de la transaction métier.
- Apache Kafka : Message delivery semantics, pour distinguer les garanties de Kafka de celles des systèmes externes.