Les agents de développement deviennent capables de prendre en charge des tâches de plus en plus complètes. Explorer un repository, comprendre une demande, modifier plusieurs fichiers, exécuter les tests, corriger leurs propres erreurs et préparer une pull request.
Je les utilise régulièrement dans mes projets. Et plus je leur confie de travail, plus un sujet me paraît important : le périmètre dans lequel on les laisse agir.
On peut avoir des instructions très détaillées, une bonne couverture de tests et une review sérieuse. Ça ne répond pas encore à toutes les questions.
Qu’est-ce que l’agent pouvait lire pendant son exécution ? Quelles commandes pouvait-il lancer ? Avait-il accès au réseau ? À des secrets ? À des outils capables de modifier des ressources externes ?
Une PR peut être correcte sans que les conditions dans lesquelles elle a été produite soient acceptables.
Des incidents qui rendent le sujet plus concret
Le 8 octobre 2026, une synthèse diffusée sur le site du projet OWASP GenAI est revenue sur plusieurs incidents et démonstrations concernant des systèmes agentiques.
Le document regroupe des situations différentes, qu’il ne faut pas confondre avec autant d’attaques indépendantes. Il ne constitue d’ailleurs pas un inventaire exhaustif.
Mais plusieurs mécanismes reviennent : des agents capables d’atteindre des ressources hors de leur périmètre, des identifiants accessibles dans leur environnement, des outils dont les permissions permettent davantage d’actions que prévu, ou encore des contenus externes qui tentent de détourner le comportement d’un assistant.
Ce qui m’intéresse ici, ce n’est pas de conclure que les agents IA seraient intrinsèquement dangereux.
Un script de déploiement mal configuré ou un compte de service avec trop de permissions peuvent déjà poser des problèmes similaires. La différence, c’est que l’agent peut choisir lui-même une succession d’actions pour atteindre son objectif.
Son périmètre réel mérite donc d’être défini autrement que par une consigne en langage naturel.
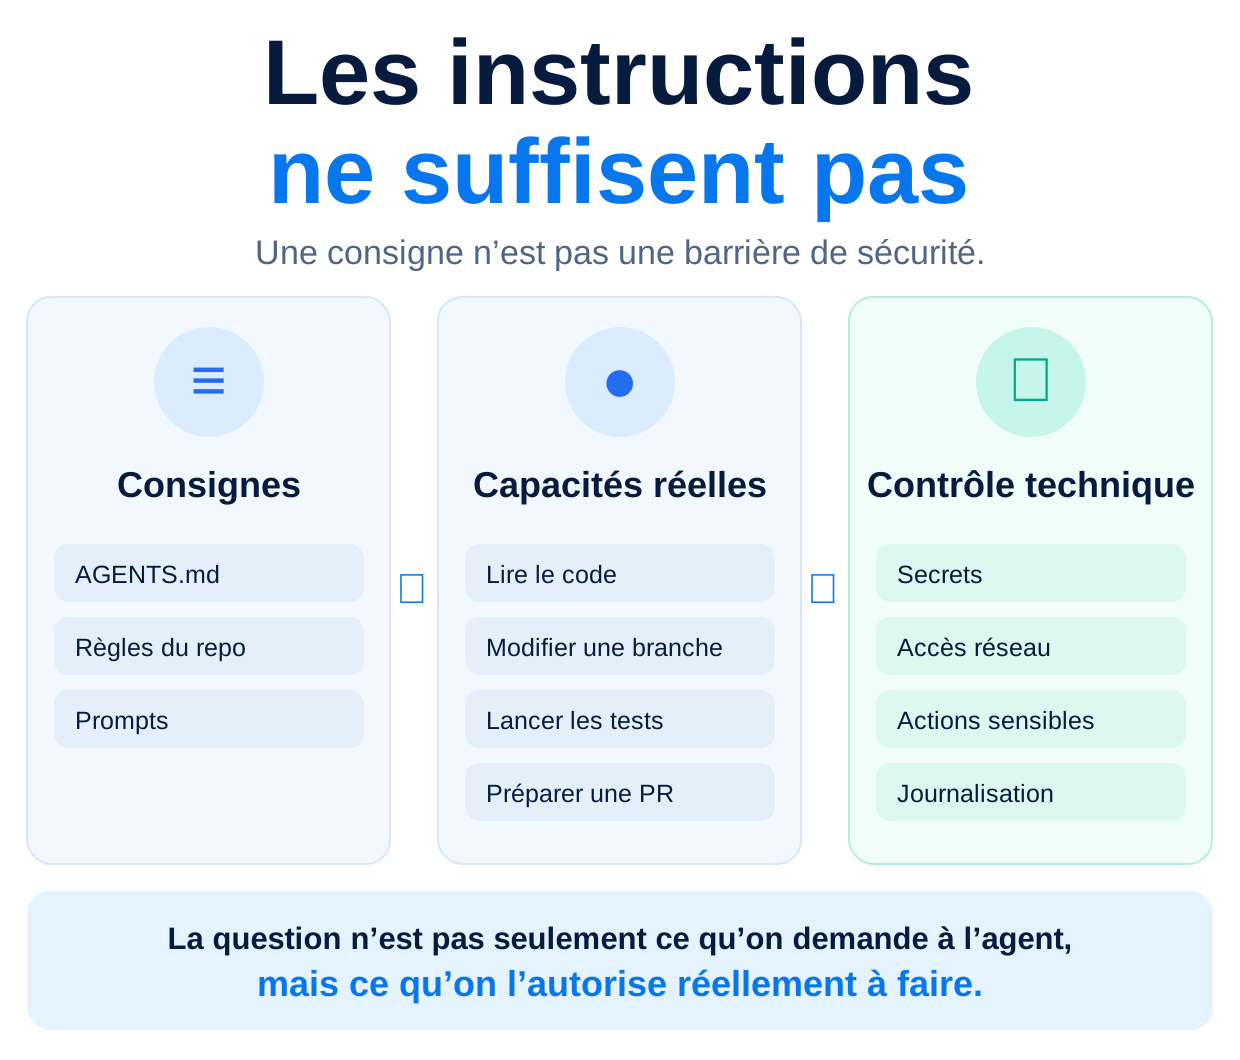
Un AGENTS.md est utile, mais ce n’est pas une frontière de sécurité
J’utilise des fichiers d’instructions pour fournir aux agents le contexte d’un projet : conventions, architecture, organisation des tests, commandes de vérification, règles de livraison, comportements interdits.
C’est très utile pour obtenir des résultats cohérents.
Mais imaginons une instruction de ce genre :
Ne jamais accéder à la production sans autorisation.
Elle exprime parfaitement une règle de travail. Pourtant, si l’environnement permet à l’agent d’utiliser des identifiants de production, d’exécuter des commandes réseau et d’appeler les outils d’administration correspondants, cette règle repose essentiellement sur son comportement.
On peut lui demander de respecter une limite. Il vaut mieux également l’empêcher de la franchir sans une autorisation extérieure au modèle.
C’est la différence entre une instruction et une permission réellement imposée par le système.
Les deux sont utiles, mais elles n’ont pas le même rôle.
Le cas concret d’un agent qui corrige une API
Prenons une tâche assez banale.
Un agent doit corriger un défaut de validation sur un endpoint. Il a besoin de comprendre le comportement attendu, de parcourir le repository, de modifier le code et d’exécuter les tests.
Dans une configuration raisonnable, on peut lui donner :
- l’accès en lecture au code et à la documentation nécessaires ;
- le droit de modifier les fichiers de sa branche ou de son workspace ;
- la possibilité d’exécuter les tests et les commandes de développement autorisées ;
- un accès réseau limité aux services réellement nécessaires ;
- la possibilité de préparer une PR sans la merger automatiquement.
À ce stade, pourquoi lui donner également accès aux credentials de production, à l’administration du cloud ou au déploiement ?
Ça n’apporte normalement rien à cette tâche.
Et si une opération particulière nécessite davantage de permissions, il est possible de traiter cette exception au moment où elle apparaît.
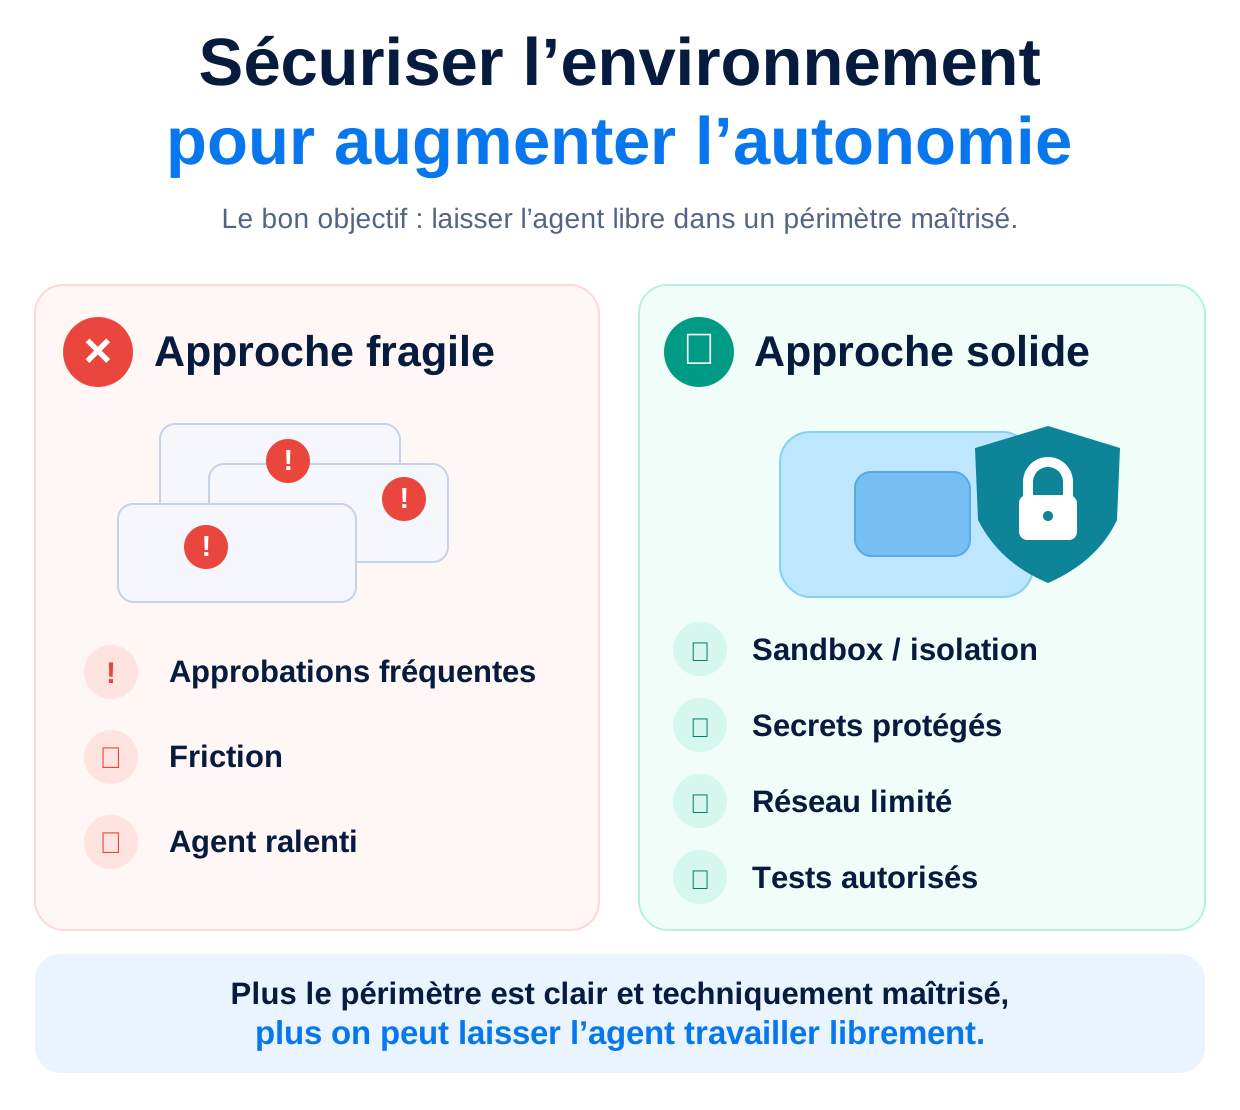
Ce fonctionnement ne nécessite pas forcément une procédure lourde. Au contraire, une bonne configuration permet à l’agent d’enchaîner les actions ordinaires sans interrompre le développeur à chaque commande.
L’approbation devient utile lorsque l’agent veut dépasser le périmètre convenu, pas lorsqu’il fait simplement son travail.
Le vrai périmètre dépasse le repository
Il serait assez facile de s’arrêter aux permissions de lecture et d’écriture sur les fichiers.
Sauf qu’un environnement de développement moderne donne accès à beaucoup d’autres ressources : terminal, GitHub, CI/CD, gestionnaires de packages, serveurs MCP, services cloud, bases de données, plateformes de tickets et documentation externe.
Les droits effectifs d’un agent dépendent de toute cette chaîne.
Un outil MCP peut être présenté comme une intégration pratique. Il faut quand même savoir s’il permet uniquement de consulter des informations ou également de modifier, supprimer, envoyer ou publier.
Même chose pour l’accès réseau. Autoriser l’installation de dépendances n’implique pas qu’il faille autoriser toutes les connexions sortantes. Il faut également tenir compte des commandes et scripts exécutés par ces dépendances.
Et il reste le problème des contenus non fiables.
Un agent peut lire un README, une issue GitHub, une page web ou une réponse d’API. Ces contenus sont nécessaires pour comprendre certaines tâches, mais ils ne doivent pas pouvoir redéfinir ses instructions ou ses permissions.
C’est notamment le principe des attaques par prompt injection : faire passer des instructions contenues dans une source moins fiable pour des consignes que l’assistant devrait exécuter.
On peut améliorer la résistance du modèle à ce genre de tentative. On ne devrait pas pour autant compter uniquement là-dessus pour protéger les systèmes auxquels il est connecté.
Donner de l’autonomie selon le risque réel
Je trouve intéressant de raisonner par type d’action plutôt que d’appliquer exactement les mêmes règles à tout le monde et à toutes les tâches.
| Action | Autonomie envisageable |
|---|---|
| Lire du code ou analyser une PR | Élevée, dans le périmètre autorisé |
| Modifier des fichiers sur une branche isolée | Élevée avec tests et garde-fous |
| Exécuter des tests dans un environnement isolé | Élevée si les commandes et ressources sont maîtrisées |
| Installer des dépendances ou contacter des services externes | Encadrée par les politiques réseau et d’exécution |
| Accéder à des données sensibles | Permission spécifique, contrôles renforcés |
| Modifier un schéma de données critique | Revue et autorisation adaptées au changement |
| Merger vers une branche protégée ou déployer en production | Autorisation explicite selon les règles de l’organisation |
Ce tableau reste un exemple de politique, pas une configuration universelle.
Un projet personnel sans données sensibles et une plateforme bancaire ou de santé n’ont évidemment pas le même niveau de risque.
Même au sein d’une seule entreprise, un agent qui travaille sur de la documentation, un composant d’interface et une logique de facturation ne devrait pas nécessairement disposer des mêmes capacités.
Il faut aussi regarder la réversibilité : modifier un fichier versionné est généralement plus facile à annuler qu’envoyer un email, supprimer des données ou déclencher une opération externe.
C’est un critère que je trouve particulièrement utile pour déterminer les actions qu’on peut déléguer sans approbation préalable.
Comment mettre ça en place sans bloquer les équipes ?
Quand j’accompagne les équipes dans l’adoption d’agents de développement comme Codex ou Claude Code, je commence par comprendre leurs usages réels.
Comment les développeurs travaillent-ils aujourd’hui ? Quelles tâches délèguent-ils ? Quels accès leurs outils utilisent-ils ? Quels secrets sont présents sur les postes ou dans les environnements de développement ? Comment les PR sont-elles vérifiées et intégrées ?
Il faut comprendre le fonctionnement actuel avant d’imposer une politique qui risque d’être contournée parce qu’elle rend le travail trop compliqué.
Ensuite, je cherche à définir avec elles un premier périmètre utilisable : configuration commune, environnement isolé lorsque nécessaire, droits minimaux, restrictions réseau, validations sur les actions sensibles et journalisation adaptée.
Je pars de quelques cas d’usage représentatifs et je vérifie que les protections fonctionnent réellement.
Par exemple, il ne suffit pas qu’un agent accepte de ne pas accéder à une ressource interdite. Il faut pouvoir constater que l’environnement bloque cet accès s’il est tenté.
Il faut également vérifier que cette configuration reste praticable pour les développeurs. Un agent qui réclame une approbation pour chaque opération finit par perdre une bonne partie de son intérêt.
Ce n’est pas uniquement une question de sécurité. C’est aussi un sujet de delivery : quel niveau d’autonomie permet de gagner du temps sans transférer silencieusement du risque à l’équipe ?
Les outils proposent déjà une partie de ces mécanismes
Les plateformes évoluent sur ce sujet.
OpenAI a détaillé en mai 2026 son propre déploiement de Codex, avec du sandboxing, des politiques réseau, des approbations, des configurations gérées et des journaux d’activité.
Anthropic documente également les permissions, les contrôles d’organisation et les pratiques d’isolation recommandées pour Claude Code.
Ces capacités sont importantes. Elles ne dispensent pas de vérifier leur configuration effective, leur disponibilité selon l’environnement utilisé et les limites de ce qu’elles protègent.
Installer une solution entreprise ne garantit pas automatiquement que les outils, les identifiants et les workflows qui l’entourent soient correctement gouvernés.
C’est particulièrement vrai dès qu’on relie l’agent à des systèmes externes.
Ce que je retiens
Je suis plutôt favorable à laisser beaucoup d’autonomie aux agents sur les tâches où ils apportent réellement quelque chose.
Je n’ai pas envie d’un système où un développeur passe son temps à cliquer sur « autoriser » pour des actions sans conséquence.
Mais cette autonomie doit s’appuyer sur des limites que le modèle ne peut pas simplement décider d’ignorer.
Pour moi, une bonne première expérimentation en entreprise devrait donc chercher deux réponses : est-ce que l’agent permet de réaliser correctement le travail, et est-ce que son environnement l’empêche effectivement de sortir des droits prévus ?
Si on sait répondre aux deux, on a déjà une base beaucoup plus sérieuse pour élargir les usages à une équipe.